Lambda ZIP과 Container 비교: 실제 Python 의존성을 넣자 결론이 달라졌다
읽지 않는 패딩과 실제 NumPy·pandas·SciPy 의존성을 나눠 비교했다. 콜드 첫 응답, 배포 시간, S3·ECR·CI 비용에서 얻은 Lambda 배포 방식의 판단 기준을 정리한다.
Lambda 패키지가 커지면 ZIP보다 Container가 유리할까요? 처음에는 읽지 않는 파일로 용량을 늘려 비교했습니다. 150·250 MB에서는 Container의 첫 응답이 더 빨랐고, 1 GB 이미지도 약 0.5초 만에 첫 응답을 돌려줬습니다.
하지만 실제 서비스에서 용량이 늘어나는 이유는 대개 의존성입니다. NumPy, pandas, SciPy를 설치하고 실제로 import와 계산을 수행하는 실험을 추가하자 결과가 달라졌습니다. 이번 실제 의존성 조건에서는 ZIP의 콜드 첫 응답과 배포가 모두 더 빨랐습니다. Warm 응답에서는 일관된 우위가 없었습니다.
기존 글을 실제 의존성 실험까지 반영해 수정했습니다. 패딩 실험은 읽지 않는 바이트의 영향을 보여줍니다. 그것만으로 큰 Python 애플리케이션의 성능을 예측할 수는 없었습니다.
실제 의존성을 넣으니 ZIP의 첫 응답이 더 빨랐다
2026년 10월 12일, us-west-2에서 Python 3.13·x86_64·메모리 1,024 MiB 조건으로 비교했습니다. VPC, Layers, Provisioned Concurrency, SnapStart는 사용하지 않았습니다. NumPy 2.2.6에 pandas 2.2.3, SciPy 1.15.3을 차례로 추가했습니다.
같은 Linux 환경에서 설치한 파일을 ZIP과 Container 양쪽에 넣고 파일 트리의 해시를 대조했습니다. 모듈 초기화에서 라이브러리를 import하고 첫 계산을 실행했으며, 호출마다 배열 계산·groupby·FFT 결과를 검증했습니다. 실제 사용하는 조합의 비교이지만, 설치된 모든 하위 모듈과 데이터 파일을 읽는 실험은 아닙니다.
조건별 새 함수 20개를 만들고 각각 cold 1회와 같은 실행 환경의 warm 5회를 측정했습니다. 아래는 cold n=20, warm n=100의 중앙값입니다. 클라이언트 시간은 같은 리전의 실행기에서 SDK 호출 시작부터 응답 본문 수신 완료까지입니다.
| 실제 의존성 · 비압축 앱 크기 | ZIP 첫 응답 | Container 첫 응답 | ZIP Warm | Container Warm |
|---|---|---|---|---|
| NumPy · 57.8 MB | 672 ms | 1,032 ms | 23.6 ms | 24.5 ms |
| + pandas · 103.2 MB | 2,409 ms | 2,682 ms | 26.3 ms | 25.5 ms |
| + SciPy · 223.1 MB | 3,472 ms | 3,709 ms | 26.9 ms | 27.1 ms |
ZIP의 콜드 첫 응답 중앙값은 Container보다 각각 약 35%·10%·6% 짧았습니다. 반면 Warm 응답은 두 방식 모두 약 24–27 ms였습니다. 콜드 호출이 많은 서비스와 이미 준비된 환경을 주로 사용하는 서비스가 체감하는 차이는 다를 것입니다.
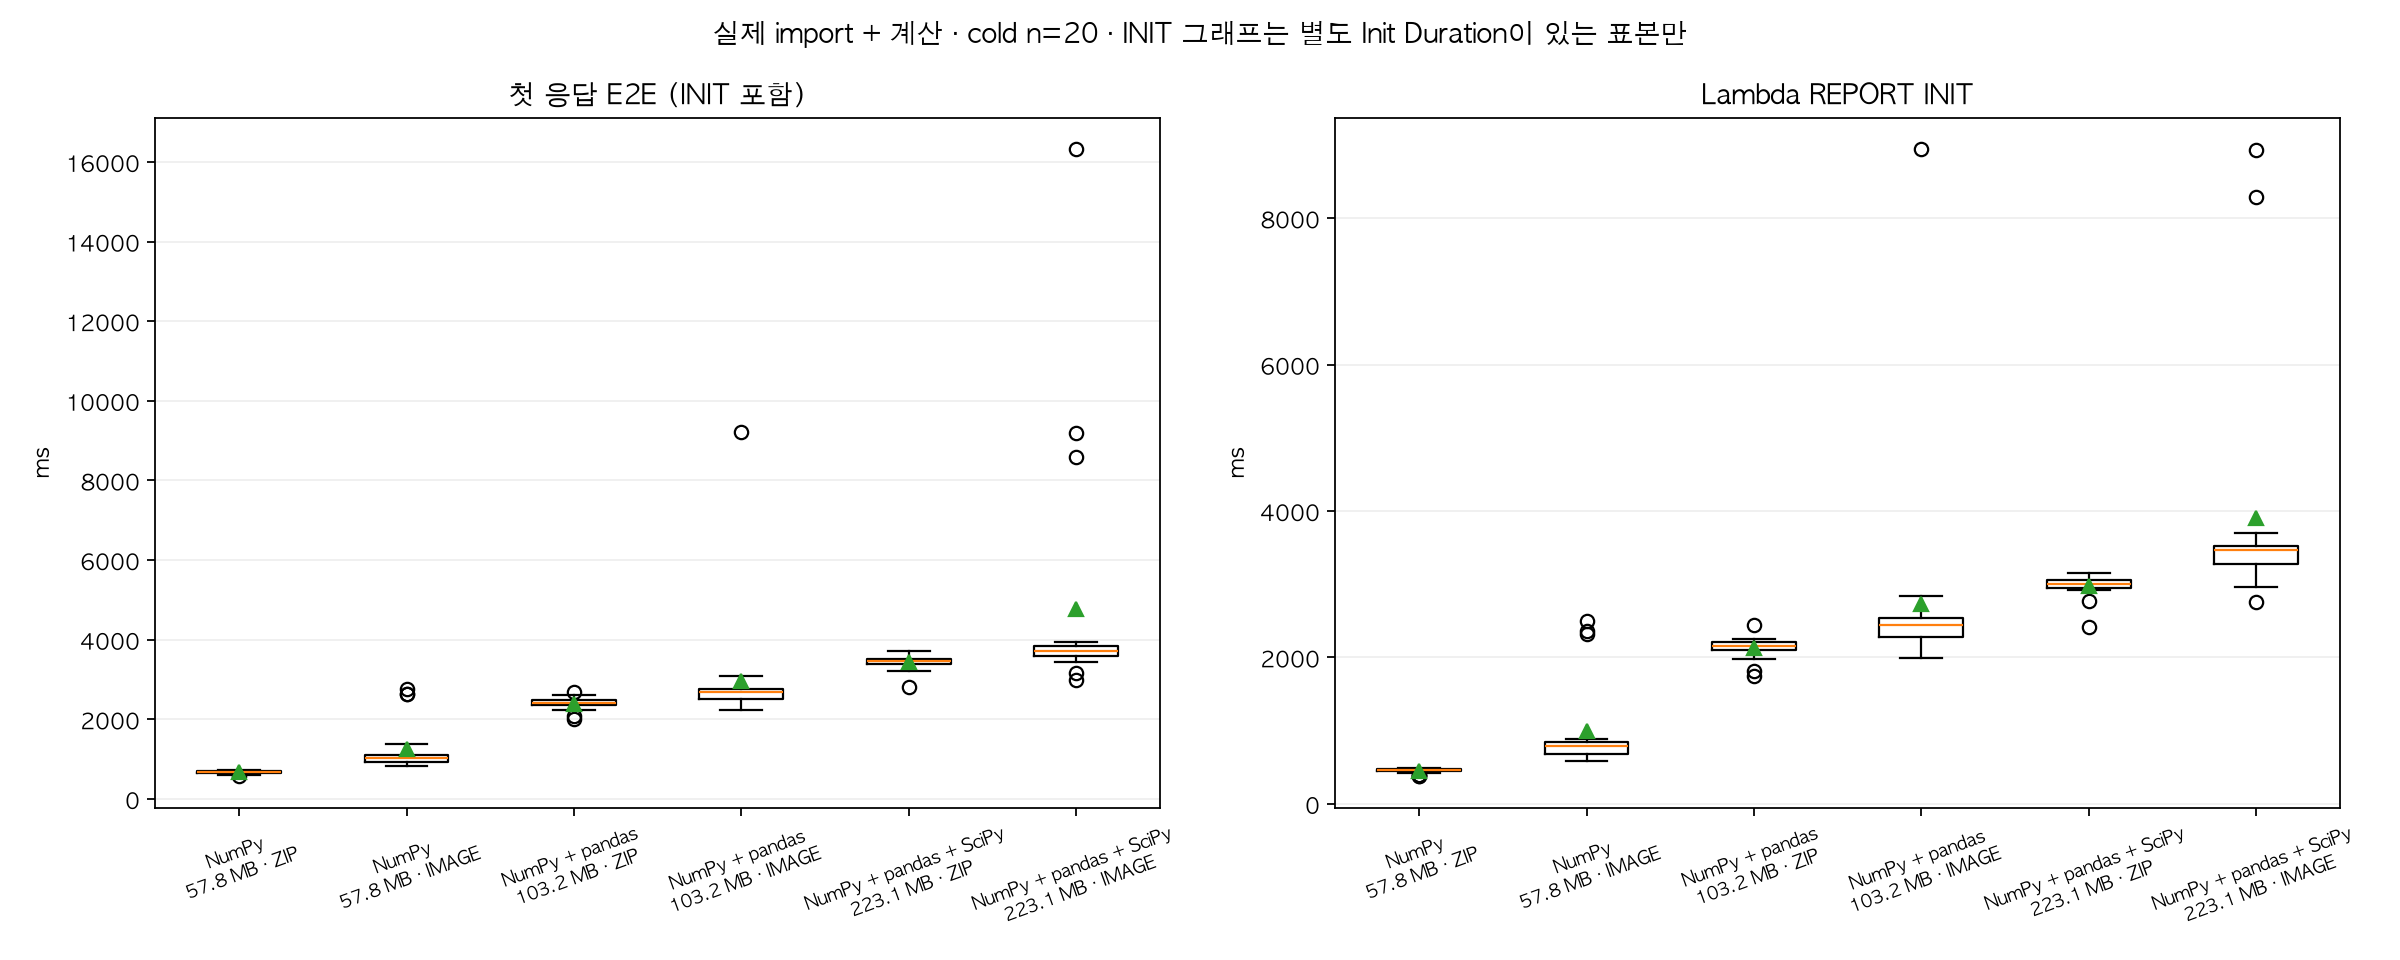
평균적인 속도만큼 꼬리 지연도 봐야 했습니다. 가장 큰 조합의 첫 응답 p95는 ZIP 약 3.64초, Container 약 9.56초였습니다. Container 한 번은 초기화 10초 제한에 걸린 뒤 호출 단계에서 초기화를 다시 수행했고, 최종 응답까지 약 16.33초가 걸렸습니다. 실패한 요청으로 버리지 않고 첫 응답 통계에 포함했습니다. 다만 cold 20개의 p95이므로 이 비율을 운영 장애율로 해석할 수는 없습니다.
INIT는 고정된 배포 방식의 특성이 아니었다
읽지 않는 패딩 실험에서는 ZIP INIT가 약 89 ms, Container INIT가 약 237–301 ms였습니다. 실제 의존성을 넣자 ZIP INIT 중앙값은 약 461 ms → 2,163 ms → 3,003 ms로, Container는 약 796 ms → 2,442 ms → 3,469 ms로 늘었습니다. 마지막 Container INIT 통계는 별도 Init Duration이 기록된 19개 표본 기준입니다.
“Container INIT는 크기와 무관하게 약 300 ms”라는 해석은 실제 의존성에 적용되지 않았습니다. import에는 Python 모듈 읽기와 실행, 네이티브 라이브러리 로딩, 초기 계산이 추가됩니다. 캐시와 지연 로딩이 있어도 실제 필요한 작업의 비용까지 사라지지는 않습니다.
측정 지표도 구분해야 합니다. 첫 응답 E2E에는 INIT가 이미 들어 있으므로 둘을 더하면 중복입니다. E2E에서 INIT를 뺀 나머지 역시 모두 응답 생성 시간은 아닙니다. 요청 전달과 실행 환경 준비 등 다른 지연이 섞입니다. AWS 실행 환경 문서에 따르면 초기화가 호출 단계에서 다시 수행될 때는 별도 Init Duration 없이 REPORT Duration에 포함될 수도 있습니다. 이때 Duration을 핸들러 실행 시간으로만 읽으면 잘못된 결론에 도달합니다.
배포도 ZIP이 빨랐지만, 레이어 구성이 비교 조건이었다
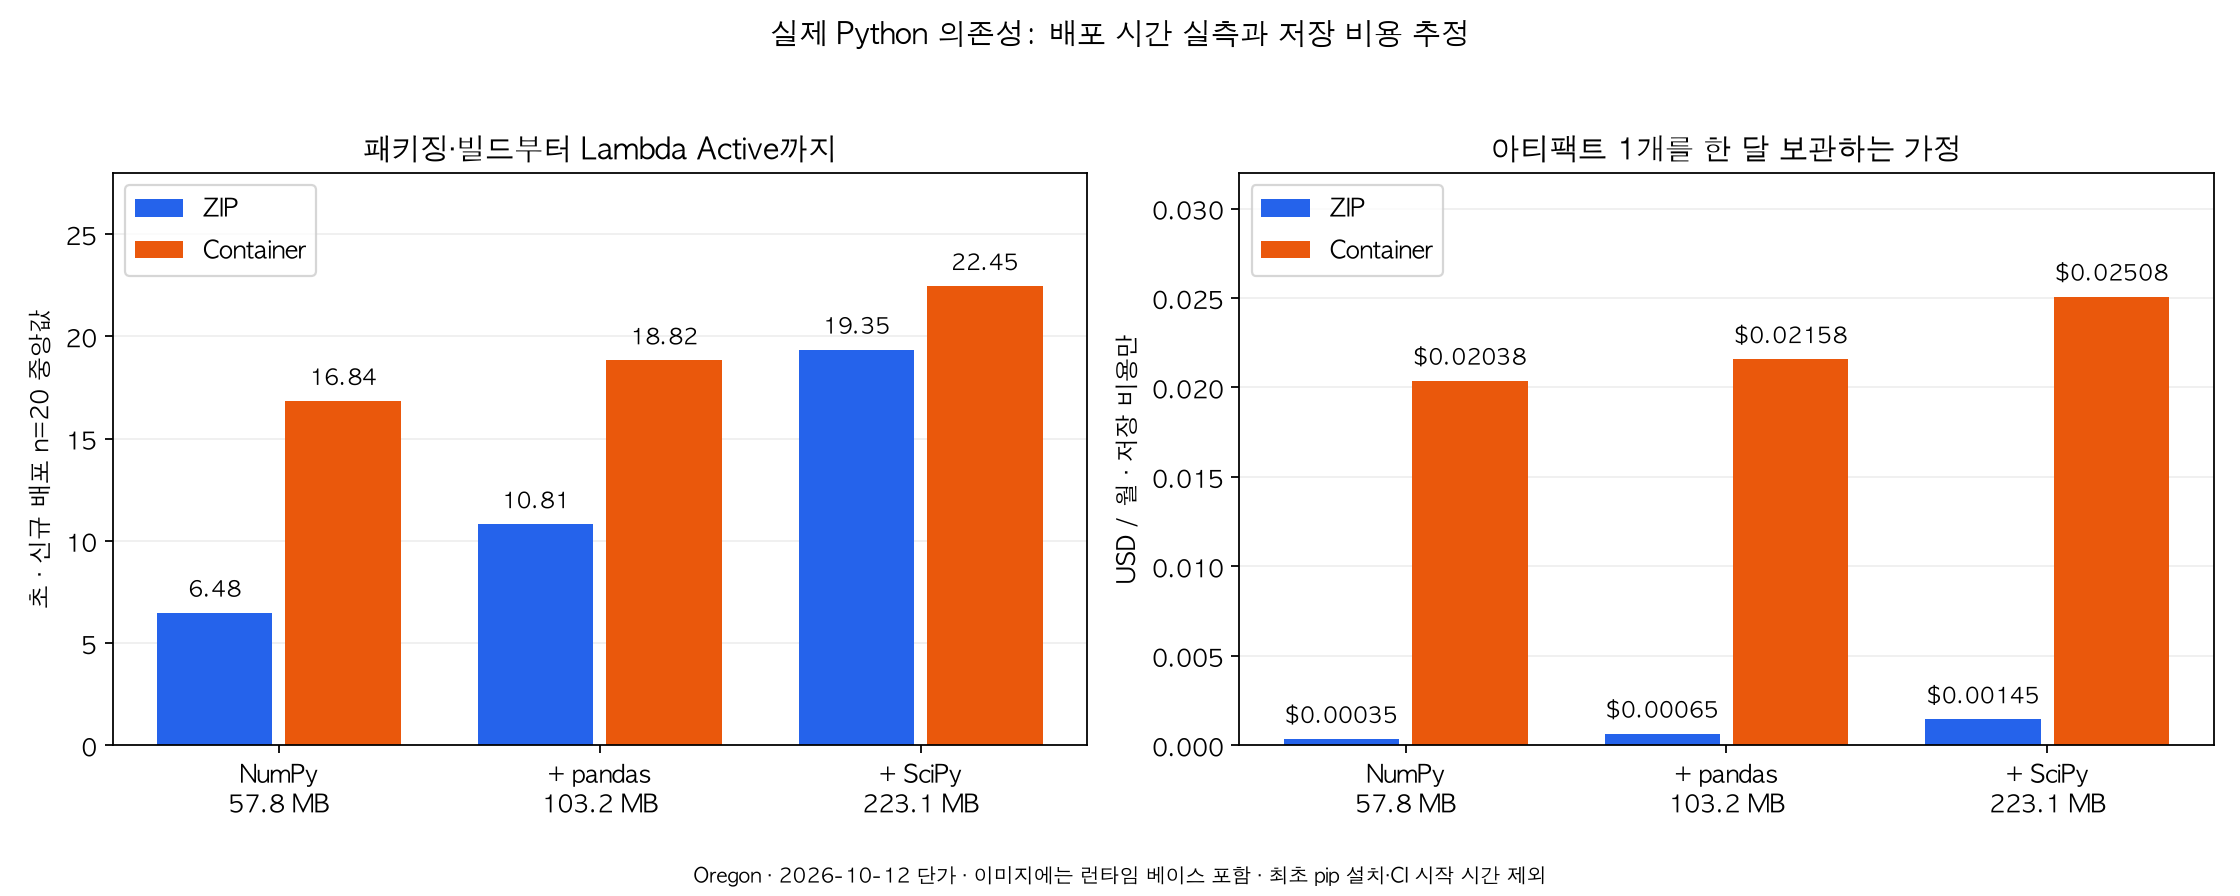
아래 ‘배포’는 업로드부터 Lambda Active 확인까지, ‘전체’는 ZIP 생성 또는 Docker 빌드까지 포함한 시간의 중앙값입니다. 최초 pip 설치, CI 실행기 시작, 실험용 해시 검증 시간은 제외했습니다. Active 확인은 1초 간격으로 폴링했습니다.
| 실제 의존성 | ZIP 배포 | Container 배포 | ZIP 전체 | Container 전체 |
|---|---|---|---|---|
| NumPy | 4.56초 | 16.30초 | 6.48초 | 16.84초 |
| + pandas | 7.20초 | 17.93초 | 10.81초 | 18.82초 |
| + SciPy | 11.69초 | 20.95초 | 19.35초 | 22.45초 |
ZIP은 압축에 시간이 더 들었지만 업로드가 빨랐습니다. 실제 의존성의 ZIP 크기는 약 16.5·30.4·67.7 MB로 줄었습니다. Container에서는 업로드와 Lambda 준비 대기가 더 길었습니다. 의존성이 커질수록 ZIP 압축 시간이 늘면서 전체 시간 차이는 좁아졌습니다.
이번 Container는 의존성과 릴리스 정보를 같은 앱 레이어에 넣었습니다. 매 배포마다 릴리스 정보가 바뀌어 앱 레이어 전체를 다시 push했습니다. 반면 기존 패딩 실험은 큰 레이어를 재사용했습니다. 1 GB Container의 첫 전체 빌드·push는 약 69.8초인 파일럿 n=1이었고, 큰 레이어 재사용 후 신규 함수 배포는 약 21.2초인 중앙값 n=30이었습니다.
이 차이는 운영의 Dockerfile 구성에 따라 결과가 바뀔 수 있다는 뜻입니다. 안정적인 의존성을 별도 레이어로 분리하면 반복 배포를 개선할 여지가 있습니다. 실제 의존성 실험에서 그 최적화의 효과까지 측정하지는 않았습니다.
비용 차이는 ECR 다운로드보다 CI와 보관 정책에서 찾았다
ECR 요금에서 같은 리전의 ECR→Lambda 전송은 무료입니다. 따라서 이 구성에서는 이미지 크기 × cold start 횟수 × 전송 단가로 계산하지 않습니다. ECR 이미지 저장 비용은 별도입니다.
실험 당시 Oregon 공개 단가인 S3 Standard $0.023/GB-month, ECR $0.10/GB-month로 아티팩트 하나를 한 달 보관한다고 계산했습니다. 보고서의 바이트 환산은 2³⁰ bytes 기준이며, 아래 파일 크기의 MB 표기는 decimal MB입니다.
| 실제 의존성 | S3 ZIP 크기 | ECR 이미지 크기 | ZIP 보관 / 월 | Container 보관 / 월 |
|---|---|---|---|---|
| NumPy | 16.53 MB | 218.78 MB | $0.00035 | $0.02038 |
| + pandas | 30.38 MB | 231.71 MB | $0.00065 | $0.02158 |
| + SciPy | 67.66 MB | 269.26 MB | $0.00145 | $0.02508 |
이미지 크기에는 Python 런타임 베이스가 포함됩니다. 여러 버전의 공유 레이어를 ECR이 중복 저장하는 것으로 계산하면 안 됩니다. 반대로 ZIP 아티팩트를 배포 후 삭제하는 정책이라면 한 달 내내 보관하는 이 표가 실제 비용을 대신하지 못합니다.
Lambda 배포 API 자체에는 별도 배포 수수료가 없습니다. ZIP에는 S3 업로드 요청 비용이 붙으며 PUT 한 건은 $0.000005, multipart 업로드는 여러 요청을 사용합니다. 이번 실험은 같은 리전 구성과 기본 스캔 설정을 사용했습니다.
추가 실험 전체 추정 비용은 약 $0.2574였습니다. 그중 CodeBuild가 $0.25로 약 97%였습니다. 반복 배포뿐 아니라 호출과 대기까지 포함한 한 실행기의 비용이므로 방식별 배포 1회 비용으로 나누지는 않았습니다. 사용한 실행기는 분당 $0.005였고 분 단위로 계산했습니다. 별도 CI 실행이 두 방식 모두 1분 이내라면 몇 초의 배포 차이가 비용 차이로 이어지지 않을 수도 있습니다.
Lambda 실행 비용은 클라이언트 E2E가 아니라 메모리·Billed Duration·요청 수로 계산해야 합니다. ZIP과 Container 모두 INIT가 과금에 포함되므로 Billed Duration에 INIT를 다시 더하지 않습니다. 실패한 10초 초기화의 청구 처리는 확인하지 못해, 이번 추정에는 그 구간 전량에 해당하는 비용을 별도 보수적 항목으로 추가했습니다.
기존 패딩·1 GB 실험까지의 누적 추정은 약 $1.2607입니다. 공개 단가 계산이며 무료 구간·크레딧·세금은 제외했습니다. Cost Explorer 접근 제한으로 실제 청구액과 대조하지 못했습니다.
기존 패딩 실험은 무엇을 알려줬나
패딩 실험의 첫 응답 중앙값은 다음과 같습니다. 앱 크기는 decimal MB이며, 신규 함수 조건별 cold n=30입니다.
| 읽지 않는 파일을 포함한 앱 크기 | ZIP 첫 응답 | Container 첫 응답 |
|---|---|---|
| 45 MB | 431 ms | 555 ms |
| 150 MB | 819 ms | 528 ms |
| 250 MB | 1,323 ms | 584 ms |
| 1,000 MB | ZIP 한도 초과 | 488 ms |
AWS 구현 논문은 Container에서 캐시·중복 제거·블록 단위 요청 시 로딩을 결합하는 설계를 설명합니다. 읽지 않는 큰 파일의 증가가 첫 응답에 비례해 나타나지 않은 관측과 부합합니다. 다만 내부 캐시 적중률과 다운로드·압축 해제 시간을 직접 분리한 것은 아닙니다.
실제 의존성은 import로 읽는 파일이 늘고, 패딩과 달리 압축도 잘 됩니다. 두 실험은 실행 작업·압축률·실행 시각이 다르므로 같은 용량 축에서 방식의 우위를 단정할 수 없습니다. 1 GB 조건도 별도 시점에 측정했으며, 실제 1 GB 모델 로딩 속도를 뜻하지 않습니다.
Console에서는 무엇이 다른가
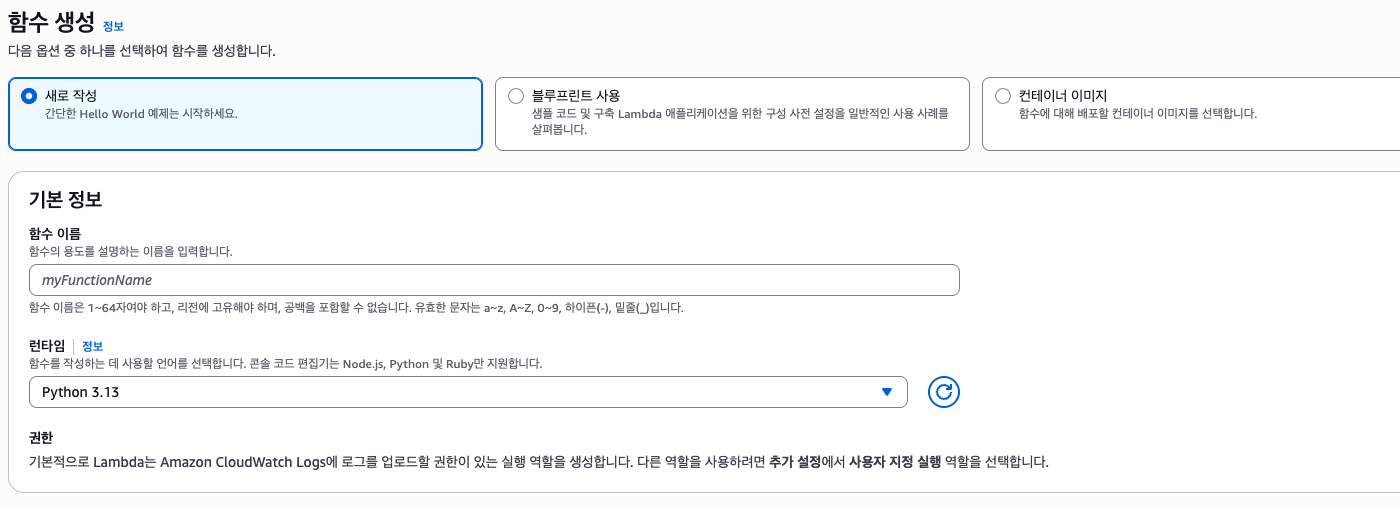
ZIP은 관리형 런타임을 선택하고 ZIP 파일을 업로드하거나 S3 객체를 지정합니다.
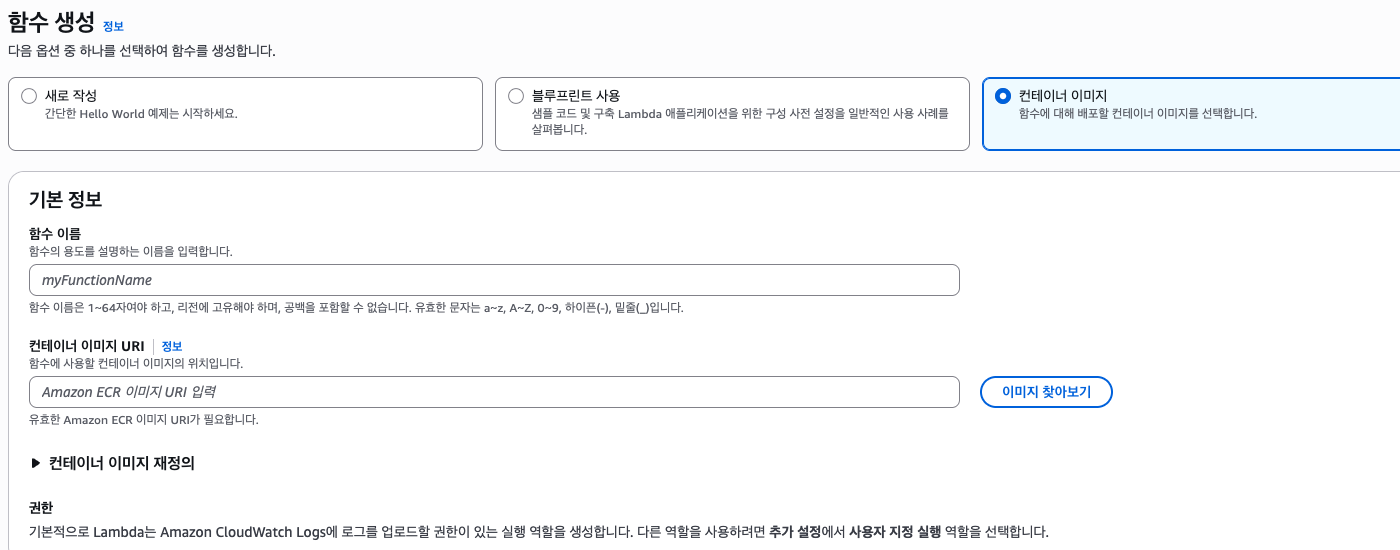
Container는 ECR 이미지 URI를 지정하고 런타임과 의존성을 이미지에 담습니다. 두 캡처는 2026년 10월 12일 실제 Console의 함수 생성 화면입니다. 배포 완료된 실험 함수의 화면은 아니며 계정 정보가 있는 상단은 제외했습니다.
다음 배포에서 사용할 판단 기준
이번과 같은 실제 Python 의존성 조건이라면 ZIP을 우선 후보로 두겠습니다. 콜드 첫 응답과 배포가 빨랐고 아티팩트 보관 비용도 낮았습니다. Warm 호출 중심의 서비스라면 응답 성능 차이는 훨씬 작게 볼 것입니다.
Container를 선택할 이유도 남습니다. ZIP의 압축 해제 250 MiB 한도를 레이어 포함으로 넘거나, OS 패키지와 런타임 구성을 직접 관리해야 한다면 이미지가 필요할 수 있습니다. 네이티브 라이브러리가 있다는 이유만으로 Container가 필수인 것은 아닙니다. 이번 ZIP에도 NumPy와 SciPy의 네이티브 라이브러리를 포함했습니다. Container의 한도는 모든 레이어를 포함한 압축 해제 이미지 10 GiB입니다.
AWS 내부 캐시는 제거하지 못했고, ZIP과 Container의 실제 Python 패치 버전은 3.13.15와 3.13.16으로 달랐습니다. 추가 실험의 본 표본 120회 배포·720회 호출은 계산 결과와 실행 환경 식별자, CloudWatch REPORT를 대조했으며 임시 AWS 자원은 삭제했습니다. 최초 전체 이미지 업로드와 의존성 레이어를 최적화한 반복 배포까지 동일한 결과라고 확대하지는 않습니다.
이번 실험에서 얻은 기준은 패키지 크기보다 실제 시작 작업을 먼저 보고, 응답 시간·배포 시간·과금 시간을 각각 측정하자는 것입니다. 큰 패키지가 Container 전환의 이유가 될 수는 있어도, 더 빠른 응답이나 더 싼 운영을 보장하지는 않았습니다.